誰の声でもない声は作れるか:声帯をまねる「物理モデル音声合成」をやさしく解説
AIでキャラクターの声を作るとき、ふつうは「誰かの声の録音」をもとにします。では、録音を一切使わず、この世に存在しない人の声をゼロから作ることはできるのでしょうか。その方法が「物理モデル音声合成」、別の言い方で「声帯再現」です。
むずかしい話になるので、できるだけ身近な例で説明します。
まず、人間の声の仕組み
声は、2つの部分の組み合わせでできています。
- 声帯の震え:喉にある声帯が震えて、「ブー」というブザーのような元の音が出ます。震えが速いと高い声、遅いと低い声になります
- 喉と口の響き:その音が、喉から唇までの管(声道といいます)を通るときに響き方が変わり、「あ」「い」などの違いや、その人らしい声の個性が生まれます
楽器でいうと、1がリード(震える部分)、2が管(響かせる部分)です。人の声の個性は、だいたい「管の長さと形」で決まります。体が大きい人は管が長く、声が低く響きます。
 声の仕組み。声帯の元の音は同じでも、管(声道)の形が違うと「あ」にも「い」にもなる
物理モデル音声合成とは
いま主流のAI音声は、何時間分もの録音をAIに聞かせて、声の特徴を「学習」させる方式です。
物理モデルは逆で、録音を使いません。声帯の震え方や、管の長さ・形を数字で決めて、「この形の喉なら、空気がどう震えて、どんな音になるか」をコンピュータに計算させる方式です。シミュレーション(模擬実験)で声を作る、と考えてください。
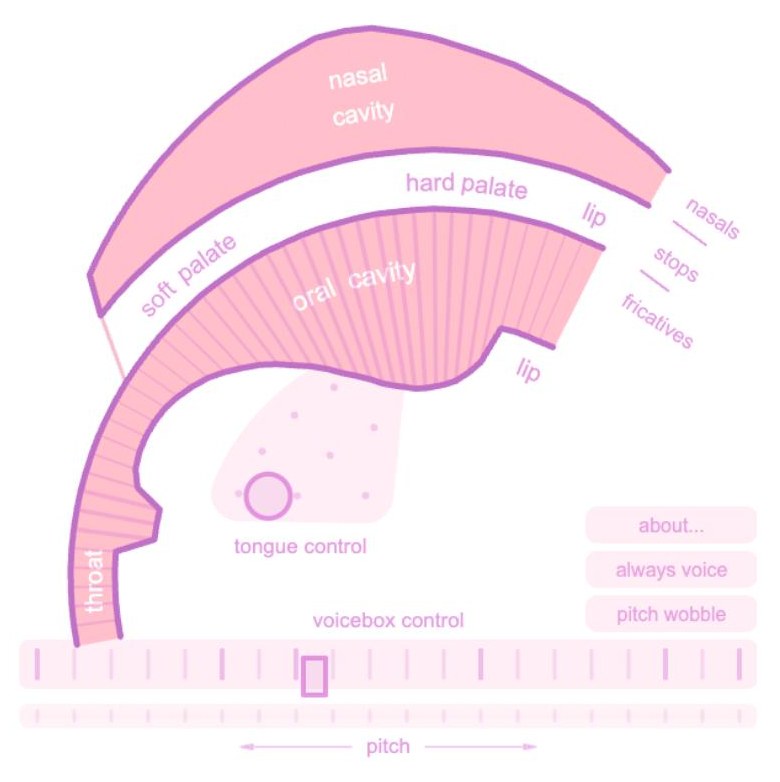
ブラウザで触れる有名なデモに「Pink Trombone」があります。画面の中の喉の断面図を指で動かすと、声の響きがその場で変わります。研究用では「VocalTractLab」というソフトが長く使われています。
Pink Trombone の画面。ピンク色の部分が声道(喉から唇までの管)で、舌や唇の位置を指で動かすと響きが変わる(2026年11月23日撮影)
何がうれしいのか
- 誰の声でもない:録音のもとがないので、「あの声優に似ている」「無断で声を使った」という問題が起きません。権利関係が一番きれいな方式です
- 数字で別人を作れる:管の長さを1cm変える、声帯の硬さを変える、といった調整で、別人格の声をいくつでも作れます
- 仕組みが説明できる:学習方式のAIは「なぜこの声になったか」を説明できませんが、物理モデルは全部が数字と計算なので、理由を説明できます
「オリジナルの声優を生み出す」という目標には、理論上いちばん近い方式です。
何が難しいのか
正直に書くと、まだ実用の品質には届いていません。理由は3つあります。
- 計算が重い:空気の流れのシミュレーションは計算量が多く、長い文章をリアルタイムで読ませるのが大変です
- 「魅力的な声」の作り方が分からない:「管を何cmにすれば可愛い声になるか」「アニメ声の甘さはどの数字に対応するか」は、誰にも分かっていません。物理の数字と、人が感じる魅力の対応表が存在しないのです
- 細かい演技が苦手:息の混ざり方、ささやき、感情のゆれのような要素は、単純な管の計算だけでは再現が難しい部分です
いまの物理モデルで作れる声は、「声らしい音」ではあっても、「キャラクターとして魅力的な声」にはまだ遠い、というのが実情です。
実際に計算だけで声を作ってみる
物理モデルの考え方を、短いプログラムで試すことができます。やることは単純で、「声帯の元の音」を作り、「管の響き」を重ねるだけです。Pythonの numpy と scipy があれば動きます。
import numpy as np
from scipy.signal import lfilter

SR = 16000  # 1秒を何個の数字で表すか
F0 = 120    # 声帯の震えの速さ(1秒に120回=低めの声)

def resonator(x, freq, bw):
    # 指定した高さの音だけを響かせる計算(管の共鳴の代わり)
    r = np.exp(-np.pi * bw / SR)
    theta = 2 * np.pi * freq / SR
    a = [1, -2 * r * np.cos(theta), r ** 2]
    return lfilter([1 - r], a, x)

def vowel(formants, seconds=0.8):
    n = int(SR * seconds)
    src = np.zeros(n)
    src[:: int(SR / F0)] = 1.0          # 声帯の「ブッブッ」という元の音
    src = lfilter([1], [1, -0.9], src)  # 高い成分を弱めて声帯らしくする
    y = src
    for f, bw in formants:              # 管の響き(共鳴)を3つ重ねる
        y = resonator(y, f, bw)
    return y / np.max(np.abs(y))

a = vowel([(800, 90), (1200, 100), (2600, 120)])   # 「あ」の管の形
i = vowel([(300, 70), (2300, 110), (3000, 130)])   # 「い」の管の形
ポイントは最後の2行です。「あ」と「い」の違いは、元の音ではなく、響かせる高さ(フォルマント)の組み合わせだけで決まっています。数字を変えれば、別の母音や、実在しない管の形の声も作れます。
この計算で作った「あ」と「い」がこちらです。録音は一切使っていません。
「あ」
「い」
母音らしくは聞こえますが、人の声らしさはまだ薄いと思います。これが物理モデルの現在地です。
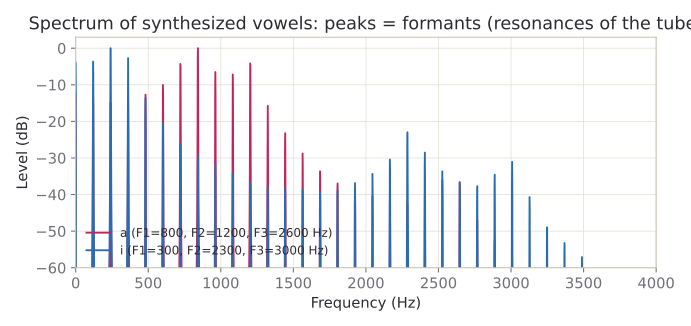 合成した「あ」(赤)と「い」(青)の音の成分。山になっている場所が管の共鳴(フォルマント)で、コードで指定した高さに山ができている
現実的な組み合わせ
そこで実務では、次のような組み合わせが候補になります。
- 物理モデルで「種になる短い音」を作る
- その音を参照音声にして、学習方式のAI(ゼロショットクローン)に文章を読ませる
種の音が誰の声でもなければ、権利の問題は小さいまま、AIの自然な読み方を使えます。ただし種の音の品質が低いと全体も引っ張られるので、現時点では、文章の指示で声を作る「ボイスデザイン」方式のほうが品質は安定しています(詳しくはTTSの技術解説記事)。
まとめ
- 物理モデル音声合成は、録音を使わず、声帯と喉の形の計算だけで声を作る方式
- 誰の声でもない声を作れるため、権利関係がいちばんきれい
- ただし「魅力的なキャラボイス」を作る方法はまだ確立しておらず、研究段階
- 当面の実用解はボイスデザイン方式で、物理モデルは将来の種音づくりとして有望
技術が進めば、「声優」という存在をデータではなく設計図から生み出す時代が来るかもしれません。その入口にある技術です。